어떻게 만드는가
장면을 설명하지 않고, 공간을 기억합니다.
공간을 구조로 읽고, 지나온 길을 기억하고, 사람마다 다르게 말하고, 확실하지 않으면 말하지 않습니다.
기존 방식과의 차이
장면을 설명하는 시스템과, 공간을 모델링하는 시스템은 다릅니다.
Image Frame · 이미지 한 장
Single Frame
현재 프레임
Visual Recognition
객체 인식
Caption Generation
문장 생성
Audio Output
음성 출력
Single-frame inference · No spatial memory
Visual Input · Camera Stream
Spatial Parsing
Object · Position · Distance · Relation
3D Spatial Model
Scene Geometry / Spatial Graph
Persistent Spatial Memory
Object Tracking / Temporal Memory
Context & Relevance Engine
User State × Environment × Priority
Adaptive Description
What to say · When to say · How to say
↻ Update · 판단 결과가 공간 모델과 기억으로 되돌아갑니다
Frame → Caption
현재 프레임을 인식하여 문장으로 변환
VS.
Space → Model → Memory → Decision
공간을 모델링하고, 기억하고, 판단하여 필요한 정보를 전달
인식 범위
네 가지 상황을 구분해서 인식합니다.
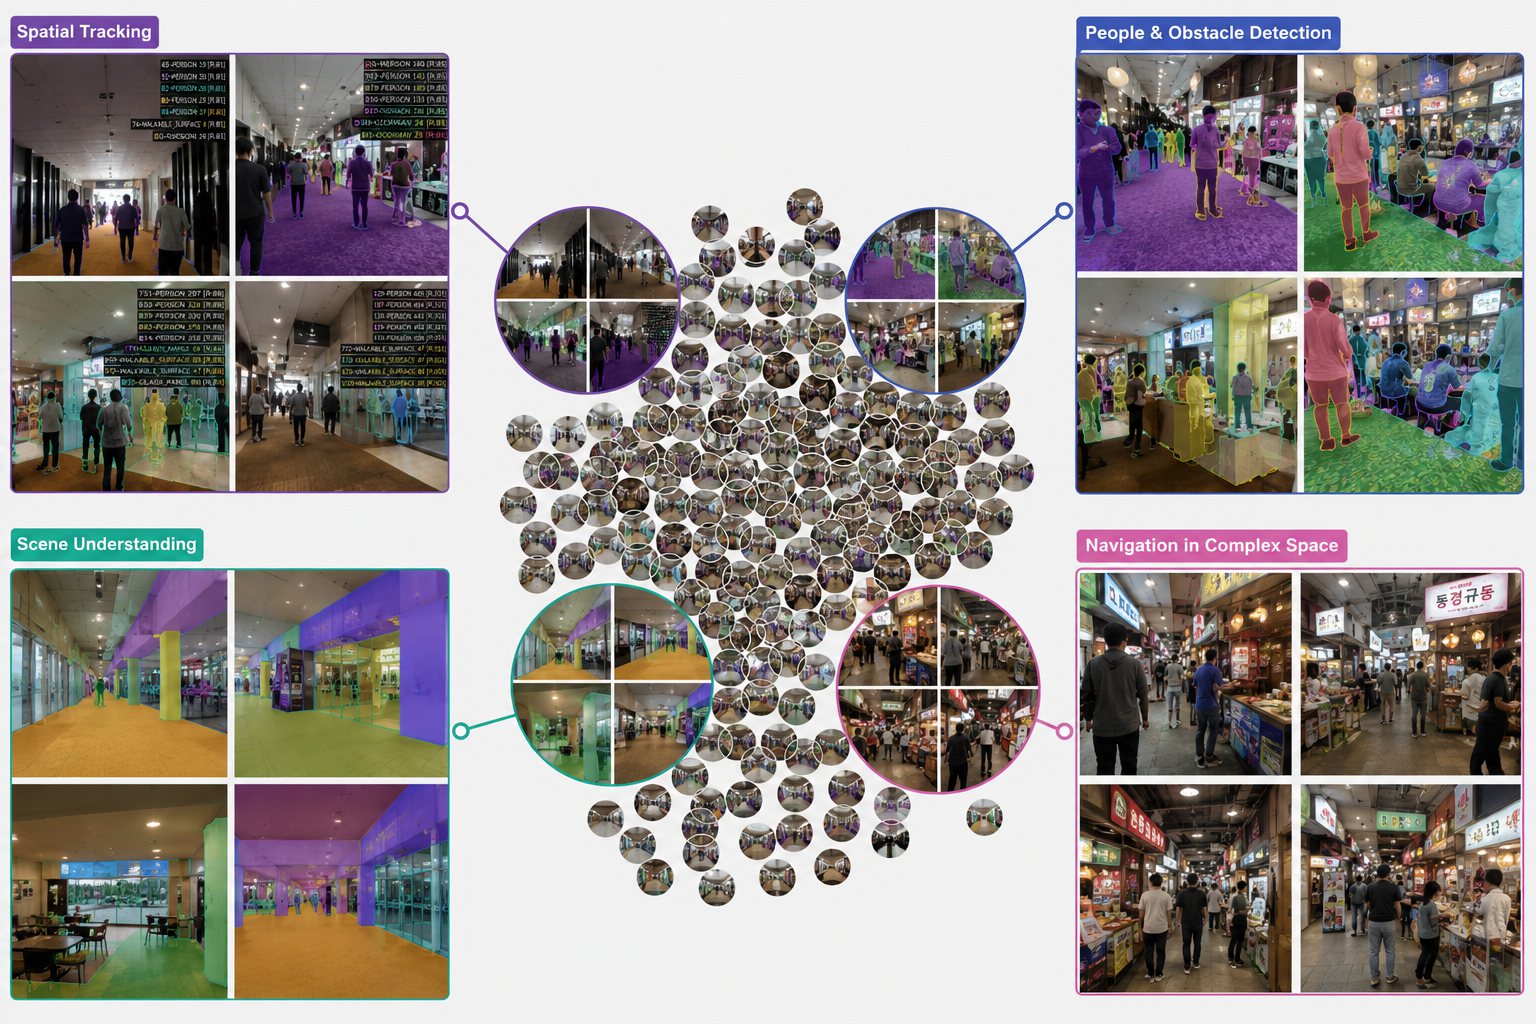
공간 추적
Spatial Tracking
복도와 통로를 따라 걷는 장면. 사람과 걸을 수 있는 바닥에 번호를 붙여 화면이 바뀌어도 같은 대상으로 따라갑니다.
사람과 장애물
People & Obstacle Detection
사람이 몰린 매장과 시장. 서 있는 사람, 지나가는 사람, 진열대와 가구를 각각 다른 것으로 구분합니다.
장면 이해
Scene Understanding
유리 벽과 기둥이 많은 실내. 어디가 지나갈 수 있는 곳이고 어디가 막힌 곳인지를 면 단위로 나눕니다.
복잡한 공간에서의 이동
Navigation in Complex Space
간판과 좌판이 빽빽한 골목. 인식이 가장 어려워지는 조건을 일부러 골라 담았습니다.
시연 영상
실제로 돌아가는 모습입니다.
실제로 만든 것을 3분짜리 영상으로 담았습니다. 영상을 보기 어려우신 분을 위해, 어떤 장면이 나오는지 아래에 글로 적어 두었습니다.
영상에 나오는 것
- 처음
- 무엇을 만드는가
- AI 안경이 본 장면을 공간 정보로 바꾸고, 그 위에서 다음 행동을 제안하는 구조를 소개합니다.
- 40초
- 말할지부터 정합니다
- 지나갈 수 있는 폭과 가까이 있는 물체를 먼저 살펴 말할지 말지를 정합니다. 대부분은 말하지 않고 끝납니다. 말하기로 정해지면 먼저 사실만 담은 문장을 만들고, 그다음 그 사람에게 맞는 말투와 정보량으로 다시 씁니다.
- 1분
- 사람을 놓치지 않습니다
- 사람이나 가방처럼 움직이는 것에 번호를 붙여, 화면이 바뀌어도 같은 대상으로 따라갑니다. 도쿄 컨퍼런스 현장에서 촬영한 영상입니다.
- 1분 40초
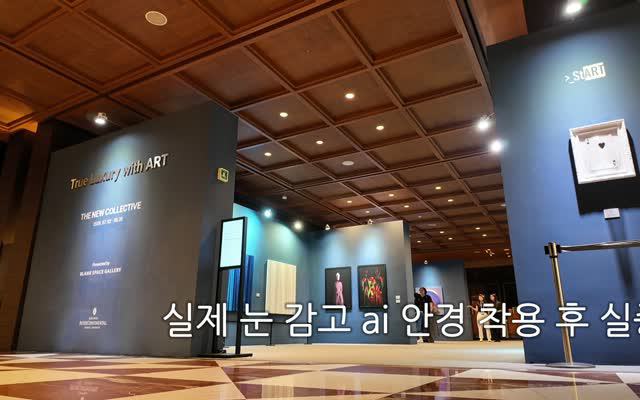
- 눈을 감고 직접 써 봤습니다
- 실제 갤러리에서 눈을 감고 AI 안경만으로 이동하며 확인한 장면입니다.
- 2분
- 여러 영상에서 공간을 다시 세웁니다
- 여러 번 촬영한 영상을 모아 전시장의 평면 구조를 복원합니다. 촬영 위치 753곳 가운데 752곳을 맞췄습니다.
기술 실증
네 가지를 실제로 돌려 본 기록입니다.
공간 축 · World State
지금 앞에 무엇이 있는가?
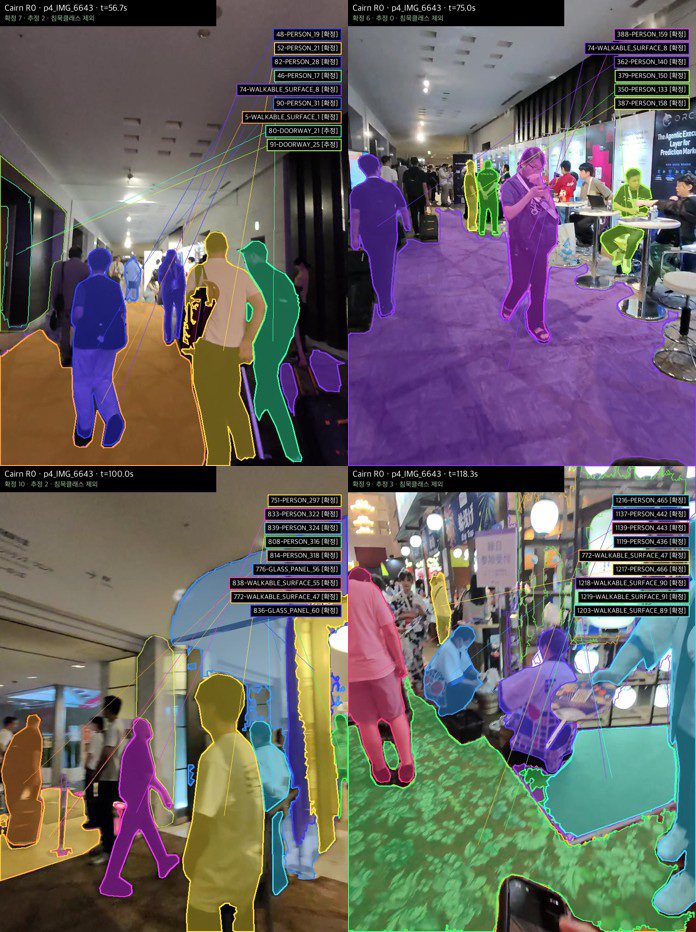
사람, 걸을 수 있는 바닥, 문, 유리 벽을 각각 다른 것으로 구분합니다. 그리고 하나하나에 이 판단이 확실한지(확정) 아니면 추측인지(추정)를 붙여 둡니다. 확실하지 않은 것은 말하지 않기 위해서입니다.
발화 판단 · Silence Policy
지금 말해야 하는가?
매 순간 말할 거리는 넘칩니다. 앞에 사람이 있다, 문이 있다, 배너가 있다. 저희는 이것을 네 단계로 거릅니다. 지나갈 수 있는 폭이 좁아졌는가, 처음 보는 것인가, 위험한가, 방금 말하지 않았는가. 대부분은 여기서 걸러져 침묵으로 끝납니다.
사람 축 · Persona
이 사람에게 필요한 말인가?
똑같은 장면을 보고도 세 사람에게 다른 문장이 나갑니다. 선천 전맹인 분께는 짧게 이동에 필요한 것만, 중도 실명하신 분께는 눈에 보이던 대로, 고령 사용자께는 천천히 친근하게. 말투만 바꾸는 것이 아니라 무엇을 말할지부터 갈라집니다.
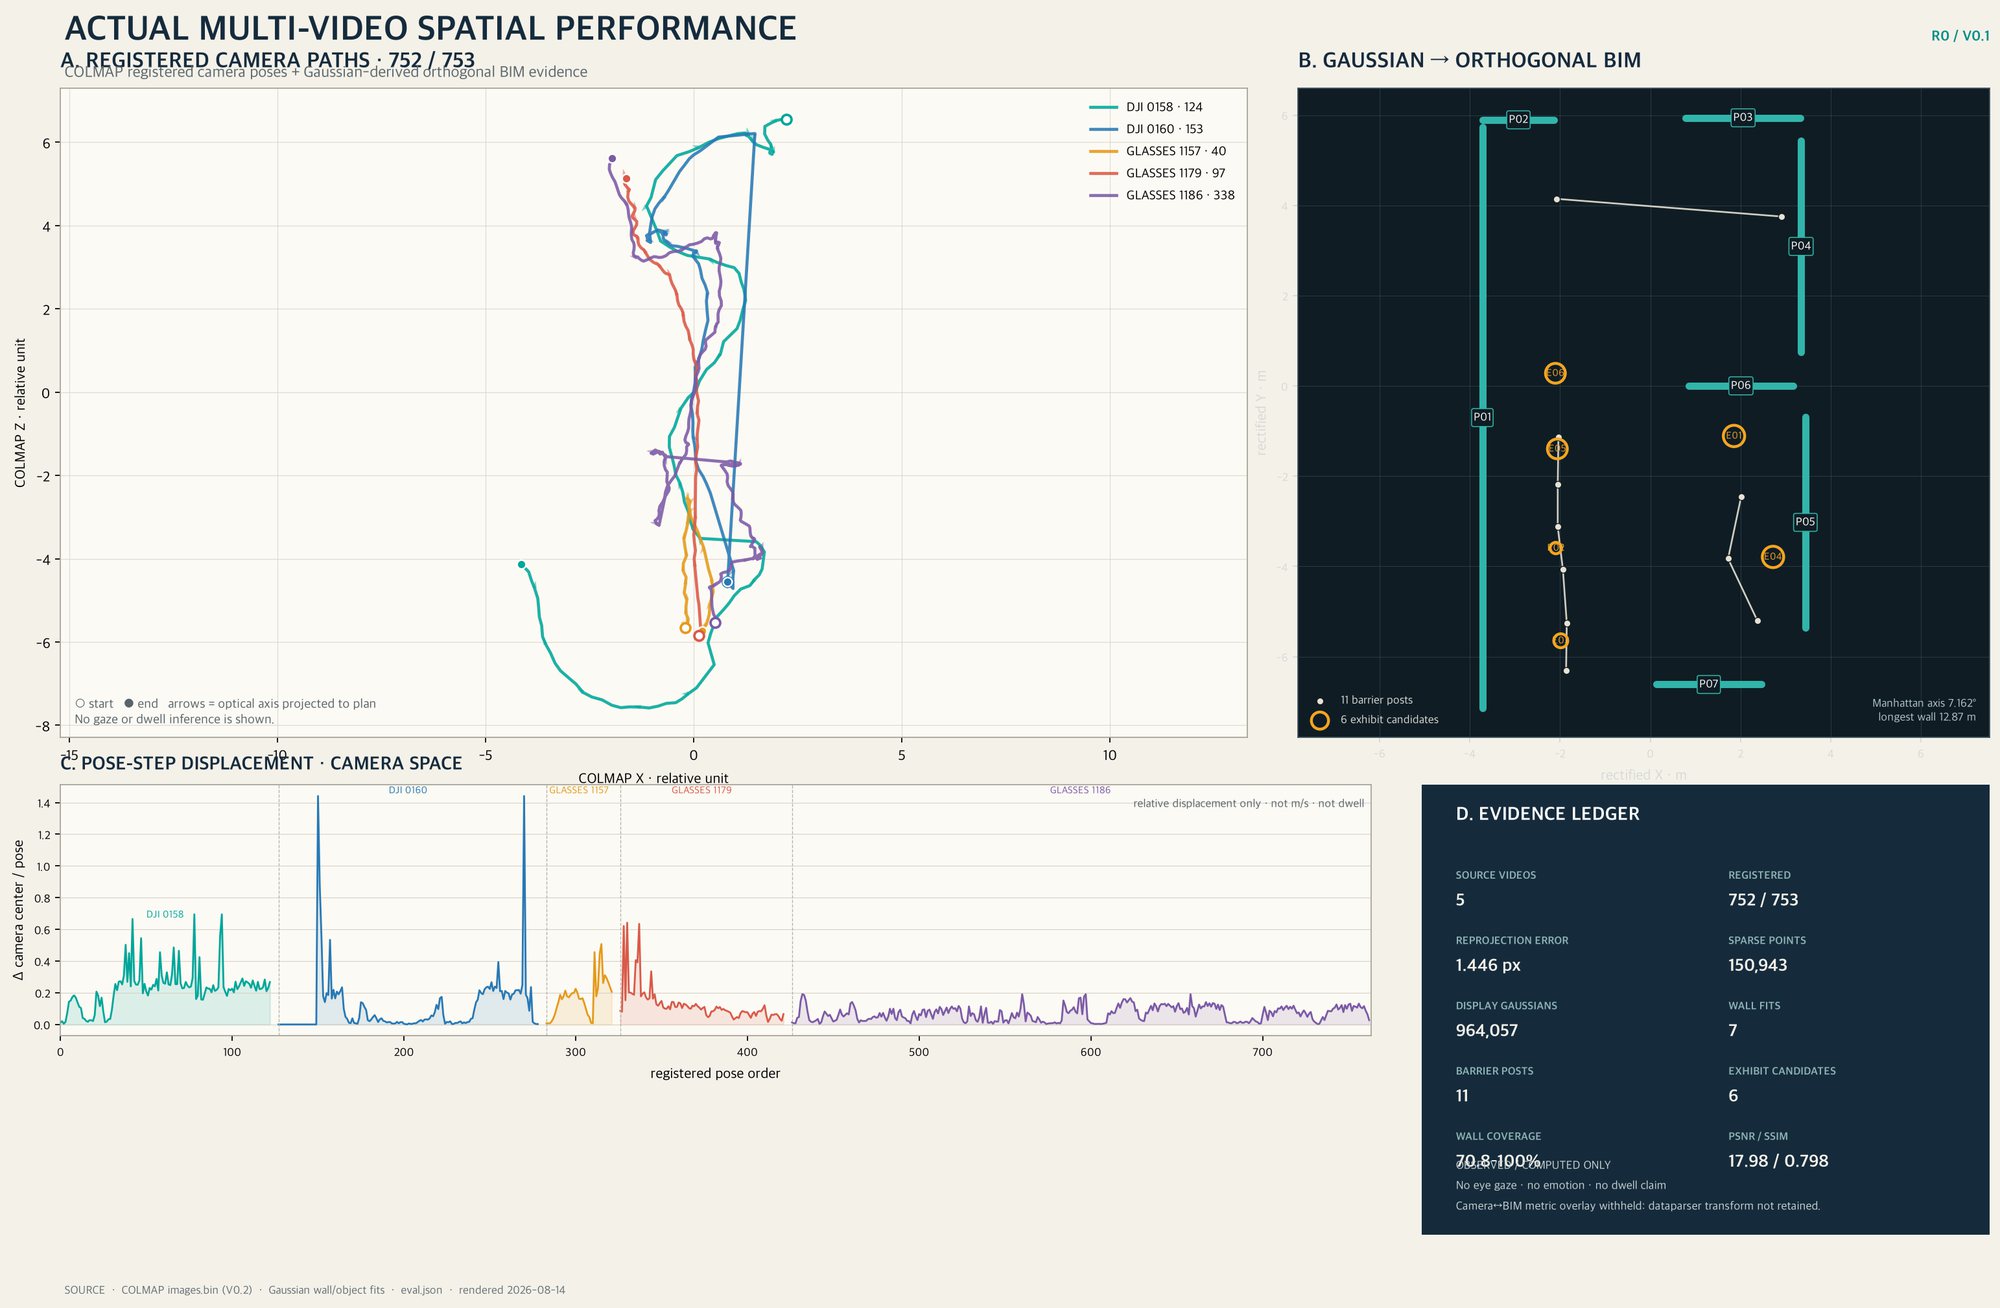
공간 복원 · Multi-video
여기가 어떤 공간인가?
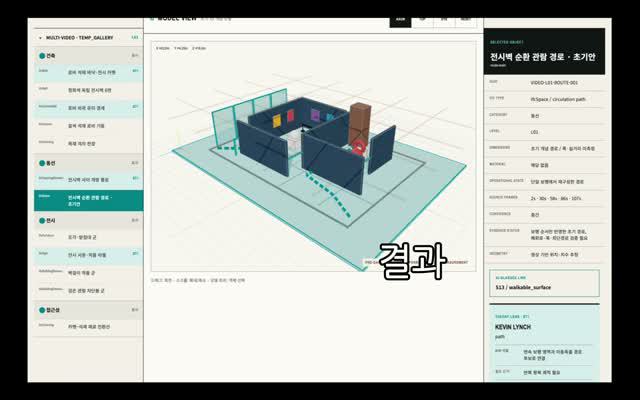
안경과 드론으로 따로 찍은 영상 다섯 개를 합쳐, 촬영한 위치를 하나의 좌표에 맞춰 놓습니다. 753곳 가운데 752곳이 맞았습니다. 그렇게 맞춘 점들에서 벽 7개와 기둥 11개를 찾아 도면으로 세웠고, 작품이 걸렸을 만한 자리 6곳을 후보로 추렸습니다.
기록 영상
만드는 동안 남긴 화면입니다.
만드는 동안 화면을 그대로 녹화해 둔 것들입니다. 잘 된 장면만 고른 것이 아니라, 그날 돌린 것을 그대로 남겼습니다.
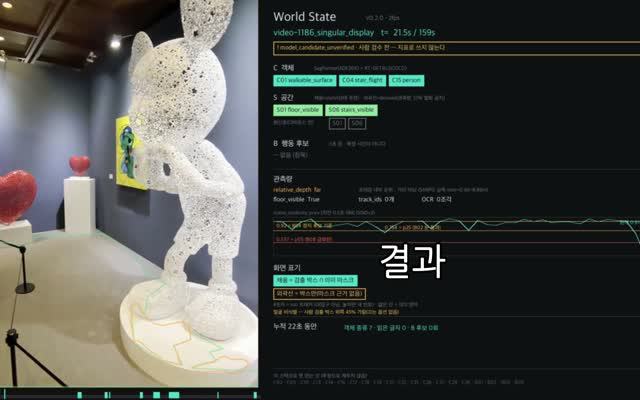
이 영상들은 사람이 검수하기 전의 기록입니다. 화면 위쪽에 붙은 경고 문구 그대로, 여기 뜨는 숫자는 저희가 성능 지표로 쓰지 않습니다. 검수를 마친 수치는 위의 기술 실증과 숫자 절에 있습니다.
걷는 동안 무엇을 재고, 무엇을 넘기는가
안경이 본 화면과 그 순간의 판단을 한 화면에 붙여 놓았습니다.
한 걸음마다 재는 것과, 지나온 길 · 20초
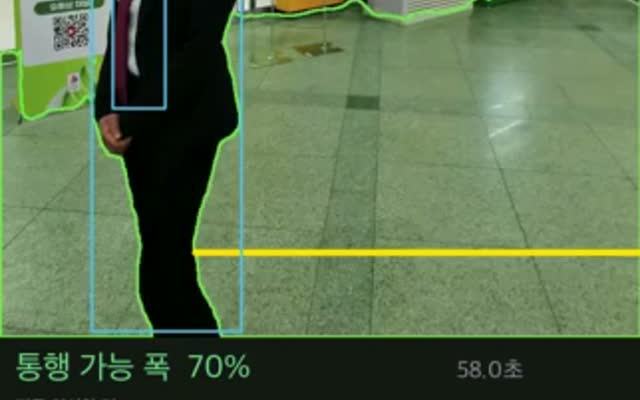
위쪽은 안경이 본 화면입니다. 걸을 수 있는 바닥이 초록으로 칠해지고, 사람마다 상자가 붙고, 오른쪽 위에 깊이가 뜹니다. 가운데는 그 순간의 판단입니다. 통행 가능 폭이 충분하니 말하지 않는다, 라고 적혀 있습니다. 아래쪽은 지나온 길을 열린 공간·통로·좁은 통로로 나눠 그린 것입니다.
45초 동안 안경이 쌓은 것 · 19초
말하지 않은 동안에도 안경은 계속 봅니다. 읽은 글자와 마주친 사물의 종류가 쌓이고, 지나온 경로가 오른쪽에 그려집니다. 눈은 들어 올린 순간만 보지만 안경은 걷는 내내 봅니다. 이 차이가 나중에 리캡으로 돌아옵니다.
사람이 몰린 입구에서도 말하지 않습니다 · 1분 40초
통행 가능 폭이 절반으로 좁아진 자리입니다. 그런데도 침묵합니다. 방금 말했기 때문입니다. 좁아졌다는 사실보다 이미 말했는지가 먼저 걸립니다. 말할 이유가 있다는 것과 말해야 한다는 것은 다릅니다.
조각내고, 번호를 유지하기
사람과 사물을 하나씩 떼어 놓고 지나가는 동안 같은 번호를 붙여 둡니다. 얼굴은 쓰지 않습니다.
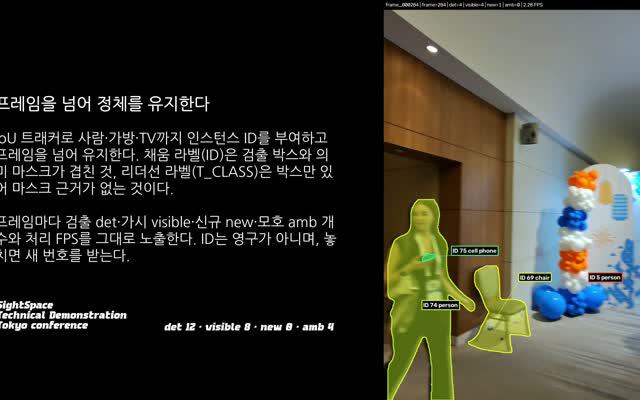
사람과 소지품에 번호를 붙여 둡니다 · 2분
사람, 손가방, 의자를 각각 다른 조각으로 나누고 번호를 붙입니다. 사람이 서로 겹치고 지나가도 같은 번호가 따라갑니다. 왼쪽 위에는 이번 프레임에 몇 개가 잡혔는지, 몇 개가 보이는지, 몇 개가 새로 나타났는지, 몇 개가 애매한지가 적혀 있습니다.
확정과 추정을 갈라 놓습니다 · 1분 14초
같은 장면을 확정과 추정으로 나눕니다. 확실하지 않은 것은 세지 않고, 말하지도 않습니다. 침묵으로 처리하기로 한 종류는 아예 목록에서 빠집니다. 사람과 걸을 수 있는 바닥에 각각 확정 표시가 붙는 것을 보실 수 있습니다.
같은 화면을 여러 장소에서
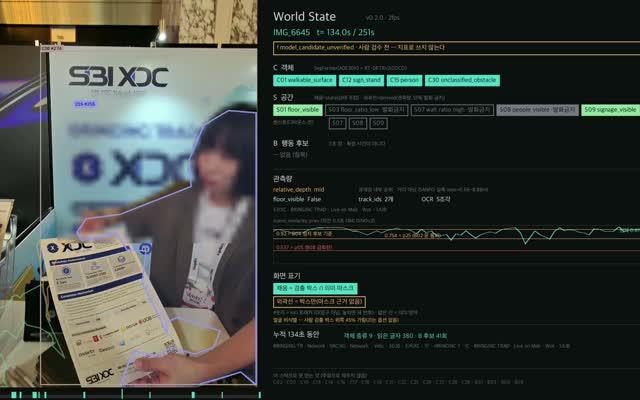
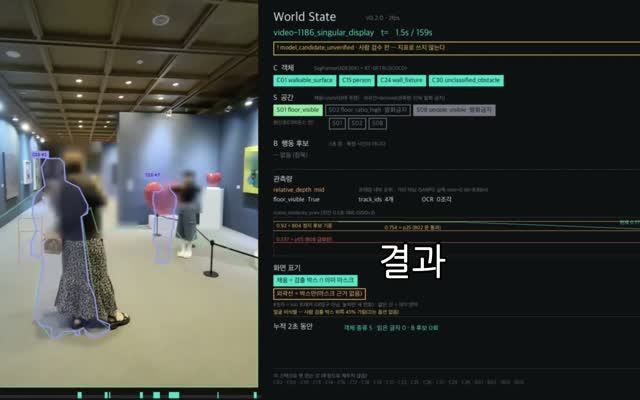
왼쪽은 안경이 본 화면, 오른쪽은 그 순간의 World State입니다. 무엇이 있는지(객체), 어떤 공간인지(공간), 무슨 일이 일어날 만한지(행동 후보)를 나눠 적습니다. 조건이 달라지면 무엇이 먼저 무너지는지 보려고 장소를 바꿔 가며 같은 화면을 돌렸습니다.
카펫이 깔린 복도 · 1분
사람이 여럿 지나가는 복도입니다. 바닥 무늬가 복잡하면 걸을 수 있는 바닥을 잡아내기가 어려워집니다. 화면 표기가 무엇을 뜻하는지도 오른쪽 아래에 같이 적혀 있습니다.
간판이 밝은 실내 상점가 · 1분
빛나는 간판과 유리가 많은 자리입니다. 글자는 잘 읽히지만, 유리와 반사가 걸을 수 있는 바닥 판단을 흔듭니다.
어두운 곳, 밝은 간판 · 4분 8초
주변은 어둡고 간판만 밝은 조건입니다. 밝기 차이가 큰 자리에서 깊이 추정이 어떻게 흔들리는지 보려고 길게 돌렸습니다.
글자가 많은 부스 앞 · 4분 11초
노트북과 안내판이 놓인 부스 앞입니다. 이 구간에서는 사람이 한자리에 머무를 만하다는 행동 후보가 실제로 떠오릅니다. 다섯 장소 가운데 행동 후보가 붙는 유일한 자리였습니다.
사람이 많은 전시장 · 5분
가장 붐비는 조건입니다. 5분을 끊지 않고 돌린 기록으로, 사람이 계속 드나드는 동안 화면이 버티는지를 봅니다.
여러 영상에서 공간을 다시 세우기
따로 찍은 영상들을 하나의 좌표에 모으는 과정입니다.
점에서 도면까지 · 24초
카메라 위치를 맞춰 점을 세우고, 여러 영상을 같은 좌표에 얹은 다음, 벽·개구부·작품·경로를 붙여 도면으로 만듭니다. 위의 기술 실증 04에 이 과정의 결과가 수치와 함께 있습니다.
현장
어디에서 찍었는가.
규모
국내 미술관 세 곳, 시각장애인 센터 두 곳과 협약을 맺고, 열다섯 곳이 넘는 실내 현장에서 직접 촬영했습니다. 전시장·컨퍼런스·매장·거리를 1인칭으로 담아 공간 객체 30종 규격서를 자체로 만들고, 1초 간격 2,037프레임을 전수 확인한 뒤 6프레임 단위로 6,822프레임을 다시 확인했습니다.
다양함
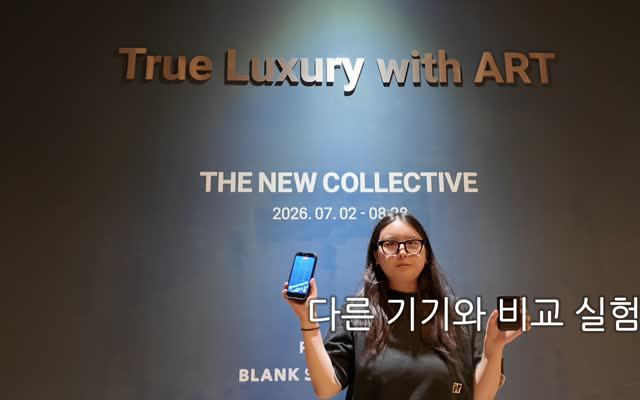
AI 안경 다섯 종류를 직접 쓰며 촬영했고, 드론으로 찍은 영상까지 같은 좌표에 얹었습니다. 밝은 전시장, 어두운 컨퍼런스장, 사람이 몰린 입구, 유리 벽이 많은 매장까지, 인식이 어려워지는 조건을 일부러 골라 담았습니다.
사생활
모든 처리는 기기 안에서 끝납니다. 촬영한 영상은 서버로 올라가지 않습니다. 얼굴이나 시선을 추적하지 않고, 누가 무엇을 얼마나 오래 봤는지 개인 단위로 남기지 않습니다.
하나의 기억, 세 가지 쓰임
같은 기억을 세 방향으로 읽습니다.
Experience Memory
지나온 순서 · 머문 곳 · 확인한 것 · 놓친 것
걷는 동안
안내 (Guide)
실시간으로 필요한 것만 말해 줍니다
이동이 끝난 뒤
기록 (Recap)
한 사람이 무엇을 확인하고 무엇을 놓쳤는지 되짚어 줍니다
여러 사람이 다녀간 뒤
리포트 (Report)
공간 운영자에게 어디가 막히는지 알려 줍니다
세 개의 다른 제품이 아니라, 같은 기억을 세 방향으로 읽는 것입니다.
어디에서 돌아가는가
인터넷 없이, 기기 안에서.
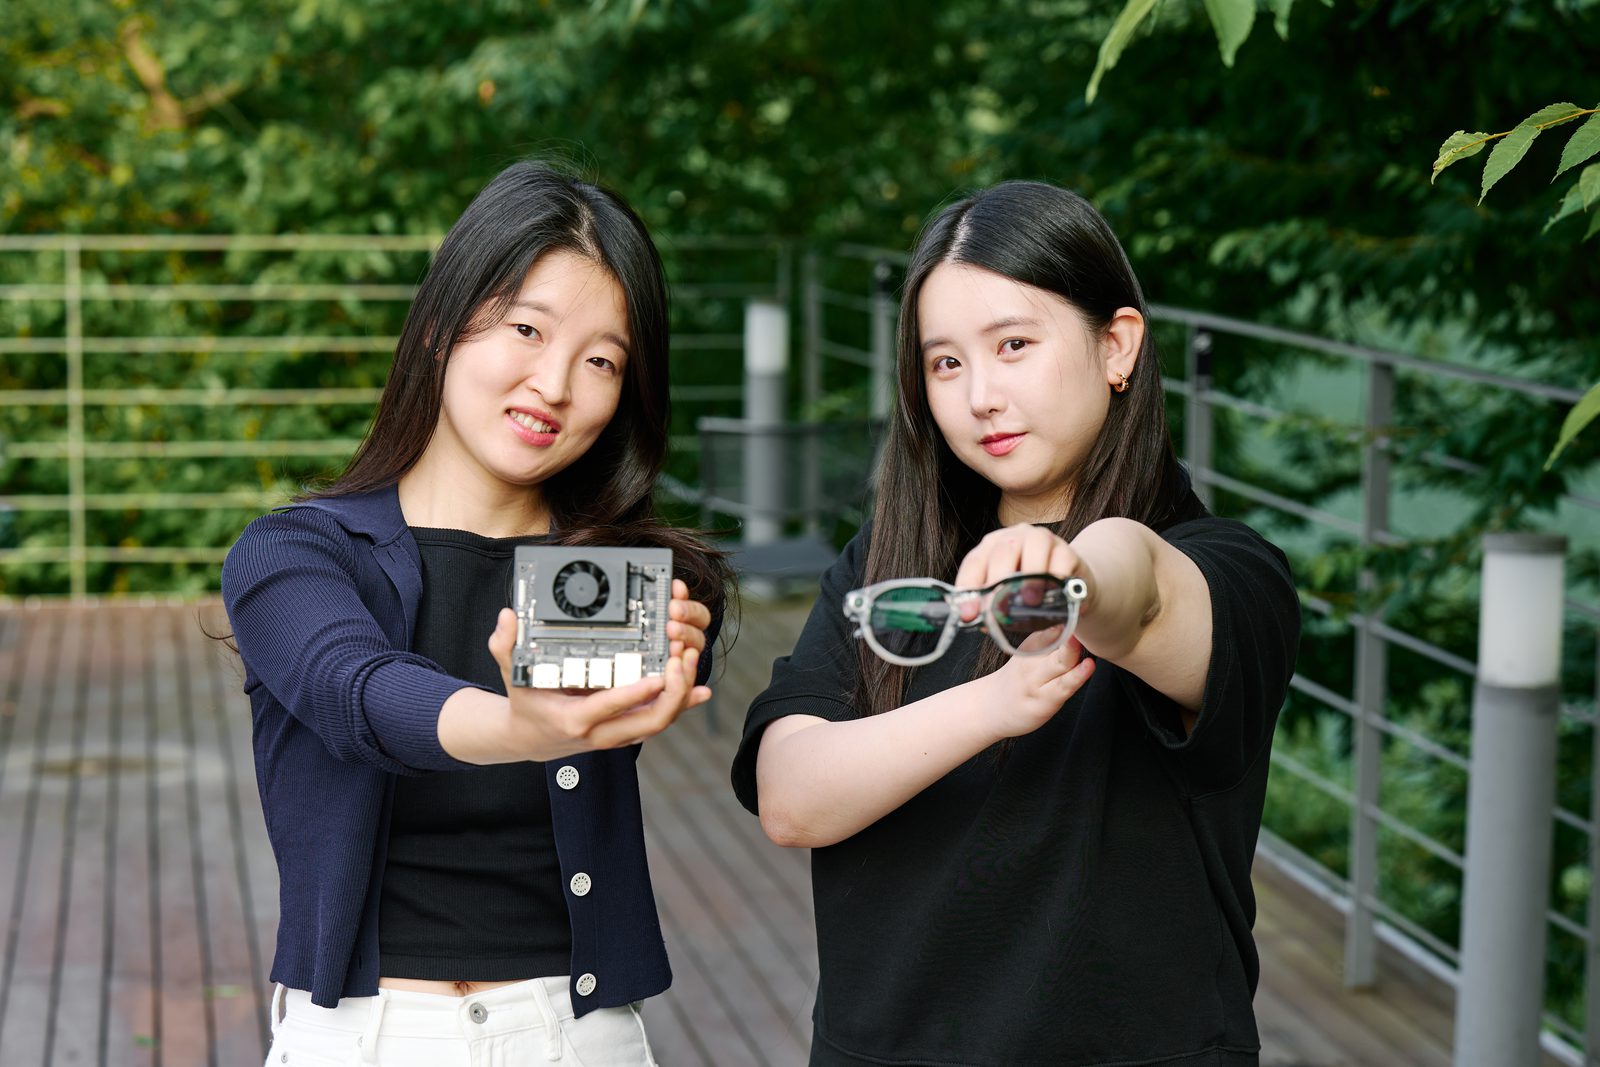
인터넷에 연결하지 않고 기기 안에서 돌아갑니다. 전파가 약한 지하 통로나 건물 안에서도 작동하고, 촬영한 영상이 기기 밖으로 나가지 않습니다.
실측 수치
실제 영상과 실제 기기에서 잰 값입니다.
실내에서 직접 찍은 300초 분량의 1인칭 영상, 그리고 실제로 쓰는 노트북과 엣지 기기에서 측정했습니다.
601번 중 14번
300초 동안 말할 수 있었던 순간과, 그중 실제로 말한 횟수
0.13초
한 장면을 읽는 데 걸리는 시간. 눈 한 번 깜빡이는 사이입니다
1.9GB
기기에 올리는 인공지능 크기. 사진 몇백 장 정도입니다
150가지
학습에 없던 사용자 조건 조합에서도 지시를 따른 경우